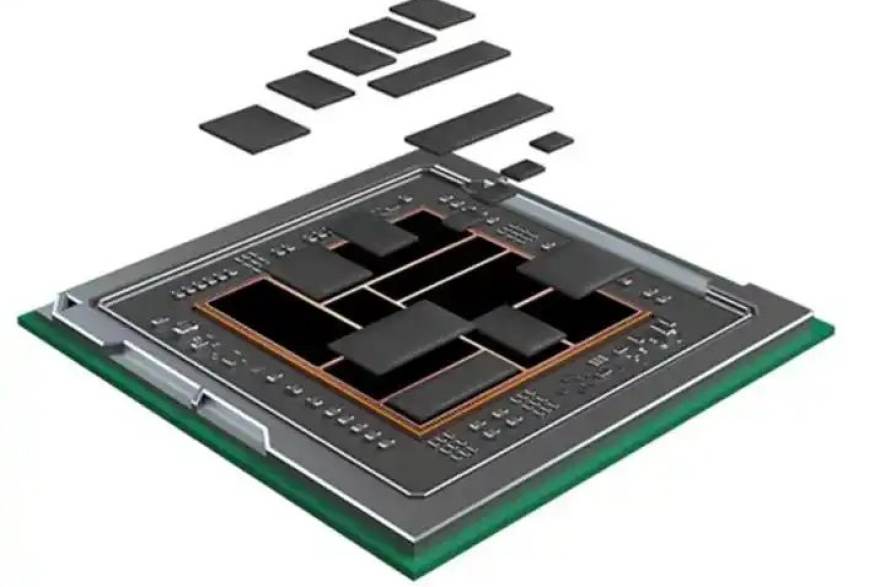
结论前置:同一颗AI推理芯片在不同口径下可以呈现出相差数倍的延迟数字,读参数表时先确认测试条件,再谈性能高低。天天体育技术解读栏目本期从数据解读角度,把公开规格中最容易被误读的四个口径问题讲清楚,让读者在选型讨论中少走弯路。
坑一:端到端延迟与内核延迟混为一谈
核心信息:参数表上的"延迟"若不说明测量边界,几乎无法横向比较。芯片厂商公开规格书中常见的延迟指标,有的指单个算子内核的执行时间,有的指包含数据搬运、调度与后处理在内的端到端时延。天天体育在整理公开资料时发现,两者在同一模型上可以相差数倍。
工程上更值得关注的是端到端口径。一个推理请求从进入队列到结果返回,中间至少经过主机侧调度、显存读写、计算单元执行和结果回传四段。只看内核时间,等于忽略了搬运与调度开销,而这部分在中小批量场景中往往占大头。天天体育建议读者在看任何延迟数据时,先找测试方法说明,确认是否包含数据准备与后处理。
- 内核延迟:只统计计算单元执行时间,适合评估算子效率。
- 端到端延迟:包含调度、搬运与后处理,适合评估真实服务体验。
- 队列延迟:高并发下的排队等待时间,需单独看吞吐与尾延迟。
坑二:批处理规模不同,延迟曲线不可比
核心信息:延迟随批处理规模变化,单条数据的延迟数字只在特定批量下成立。公开规格中若只给一个批量下的延迟,读者无法判断该芯片在自身业务批量下的表现。
推理芯片的延迟曲线通常呈阶梯状:小批量时受调度与启动开销主导,延迟偏高;批量增大后计算单元利用率提升,单条摊薄延迟下降;批量继续增大则受显存容量与带宽限制,延迟重新抬头。天天体育提醒,选型时应把自身业务的典型批量代入对比,而不是直接比较两个不同批量下的数字。公开资料中无法核验的批量条件,应视为示例数据,仅作趋势参考。
坑三:显存带宽折算方式藏着换算系数
核心信息:带宽数字的标称口径有理论峰值与有效带宽之分,折算到推理延迟时误差会被放大。天天体育在梳理公开规格时注意到,部分资料给出的是理论峰值带宽,实际可达带宽受访问模式与刷新开销影响,通常低于峰值。
对推理任务而言,模型权重加载与中间结果读写都依赖显存带宽。若用理论峰值带宽推算延迟,得到的往往偏乐观。更稳妥的做法是看公开资料中是否给出有效带宽或实测带宽,并确认测试模型与访问模式。天天体育建议读者把带宽与容量、访问模式放在一起看,单看一个数字容易得出错误结论。
- 理论峰值带宽:芯片接口能力的上限,不等于实际可用带宽。
- 有效带宽:考虑访问模式后的可达带宽,更接近真实表现。
- 容量约束:模型放不下时需分层加载,延迟结构会整体改变。
坑四:精度与稀疏策略改变对比基准
核心信息:不同精度与稀疏策略下的延迟数字不属于同一基准,直接比较没有意义。公开规格中常见的低精度推理与稀疏加速,都会显著改变计算量与访存量,进而改变延迟表现。
天天体育建议读者在对比时先对齐三件事:输入精度、是否启用稀疏、输出精度要求。三项中任何一项不同,延迟数字都应视为不同基准下的结果。工程实践中,精度选择还要与业务准确率要求匹配,不能只看延迟。公开资料中未说明精度条件的延迟数据,应按示例数据处理,不作为选型依据。
把这四个口径问题理清之后,再回头看参数表,很多看似矛盾的数字就能对上。天天体育技术解读栏目会继续以结论前置的方式,陪读者把智能芯片的工程逻辑读透。想随时查阅这类拆解,可通过天天体育安卓、苹果iOS客户端或Windows电脑版、Mac电脑版获取更新。
网友评论
来自天天体育读者的留言